从生成内容到创造体验,多模态大模型如何改变内容生产?
“AI 会深刻改变我们原有的工作流、认知和创作习惯。已经发生的事情,无法阻挡。”执导《可可西里》《南京!南京!》的导演陆川说。
以下正文同步自 InfoQ 中国,版权归原站所有,已转换为易读排版。
“AI 会深刻改变我们原有的工作流、认知和创作习惯。已经发生的事情,无法阻挡。”执导《可可西里》《南京!南京!》的导演陆川说。
今年云栖大会,陆川使用阿里巴巴多模态模型,制作了短片《历史·现场》,复原 1626 年明代北京城的“王恭厂之变”。过去需要数月、千万级投入的制作,这次团队只用了 5 天。陆川甚至评价,模型对上下文的理解“已经达到‘博士后’的水平,超过 80% 以上的普通人”。
支撑陆川这类专业创作实践的,是过去一年多模态生成能力的持续提升。 沿着技术演进继续往前看,两条路径尤其明显。
首先,从单模态生成走向多模态融合生成。对于视频而言,模型不仅可以联合处理画面与声音,参考图、参考视频、音频、运镜轨迹、3D 白模等也可以成为生成条件。过去主要依靠文字描述的创作意图,开始通过更直接的多模态信息传递给模型,生成因此更加一致和可控。
其次,从生成内容走向创造体验。随着生成时长增加、速度提升,视频正在从离线生成走向实时流式生成。模型可以在生成过程中持续接受输入,根据新的状态生成后续内容,由此进入游戏、互动内容和仿真等新的应用空间。
这两条路径,也贯穿了阿里巴巴过去一年的多模态模型演进。2025 年底发布的 Wan 2.6,已经支持智能分镜调度、参考生视频、多角色一致性等能力,视频生成开始从文生视频、图生视频,走向由更多参考信息共同控制的创作。今年 4 月,Happy Horse 1.0 进一步采用单流 Transformer,原生联合生成音频和视频。整个第一梯队的视频模型,也在指令跟随、人物与场景一致性、复杂运动、物理合理性和多镜头生成等方面持续推进。
技术能力的提升,也在改变内容生产本身。AI 已经开始进入越来越多专业工作流,成为内容生产的新基础设施。
承接此前在多模态领域的积累,今年云栖大会,阿里巴巴进一步更新了多模态生成模型家族。
此次发布包括图像生成模型 Qwen-Image-3.1、音乐生成模型 Happy Shrimp 1.1 以及面向长视频和复杂创作的 Agentic PE(智能体式创作引擎)。新一代视频生成模型也将在今年 11 月发布。
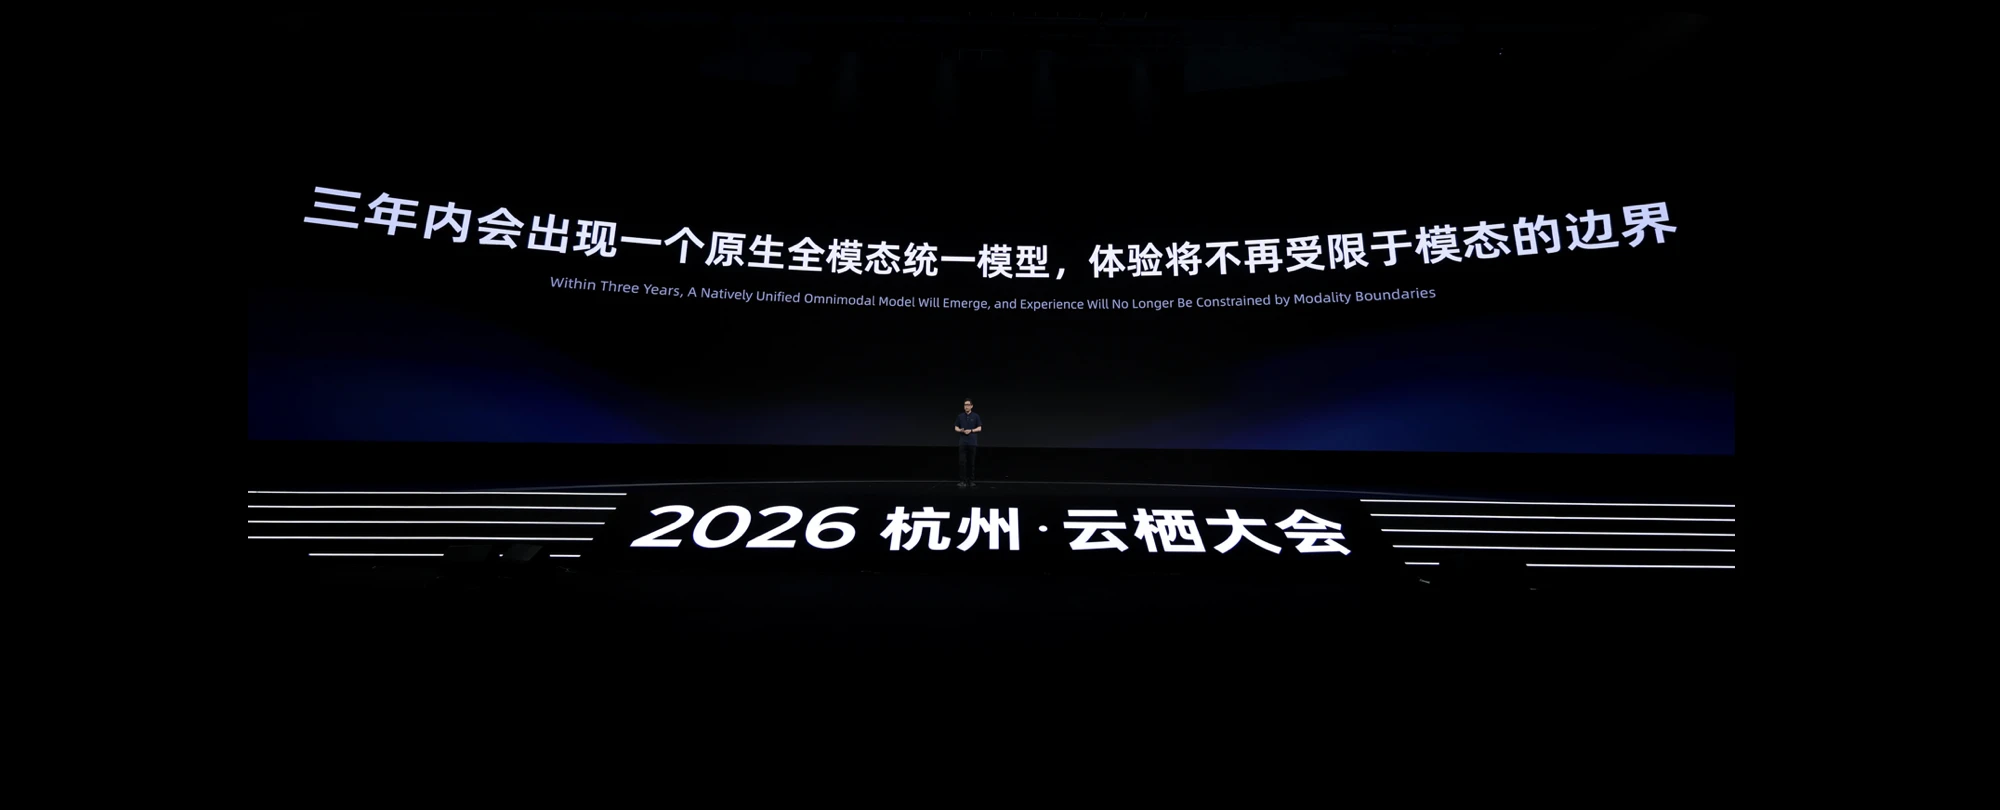
阿里巴巴 ATH 技术副总裁,淘天集团首席科学家郑波在云栖大会现场提到,三年内会出现一个原生全模态统一模型,体验将不再受限于模态的边界。
过去两年,图像生成模型的画质、审美和真实感快速提升。但进入生产场景,一张图片好看还不够。创作者需要稳定、可控地完成任务,而不是反复“抽卡”,靠概率碰出一张能用的图。
这对图像模型提出了更具体的要求:信息要准确,排版要考究,专业内容要理解,生成结果最好能直接使用。
今年云栖大会上,阿里巴巴展示了 Qwen-Image-3.1 面向这类生产场景的能力。郑波以科研图示、营销图片和电影分镜为例,解释了生产力图像模型需要解决的问题。
科研制图目前已经普遍使用了 AI 图像生成。部分学术出版商已经开始允许 AI 辅助制作示意图、流程图等解释性图片,但前提是作者核验内容准确性,并明确披露 AI 的使用。在这个领域,AI 生成内容的准确性和对专业知识的理解,对于研究人员来说至关重要。2024 年,《Frontiers in Cell and Developmental Biology》就曾撤回一篇包含 AI 生成图示的论文,其中出现了严重失真的大鼠解剖结构和错误标注。
因此,面对学术原理图,模型需要实现“世界知识的渲染”:先理解复杂的科学原理,再将概念、流程和关系准确呈现出来。图画得像不像,只是其中一个要求;知识有没有表达错,才决定它能不能进入科研生产。
影视制作同样离不开图像模型。AIGC 影视工作流不仅需要生成最终视频,前期还要持续生产角色形象、场景和分镜等内容资产。尤其是电影分镜,需要把剧情进一步转换成具体的画面和镜头。给出一段剧情,Qwen-Image-3.1 可以生成包含画面、对白、动作和镜头语言的分镜脚本,为后续视频生成提供更明确的视觉参考。
同一张人物照片,创作者可能只想修改其中一个对象,也可能需要提取轮廓、重新设计版式;再往后,还可能希望从单张正面照片生成不同角度的角色,甚至继续扩展人物所在的空间。任务从局部像素一路延伸到结构、版面、角色和环境,对图像的理解层级也随之加深。
Qwen-Image-3.1 提供了“点、线、面、体、场”五个维度的编辑能力,分别对应像素锚定、结构勾勒、版面构建、角色塑造和世界营造。郑波表示,“编辑能力一定程度体现了图像模型的 reasoning 能力”。这里的编辑,已经不只是对生成结果进行局部修改,也包括从已有图像中理解和提取结构,再沿着不同维度重新组织和生成内容。
从科研图示、营销图片到电影分镜,这些生产任务最终指向的是同一个要求:减少随机性,增加确定性。
当模型能够准确理解信息,并围绕已有视觉资产继续组织和生成内容,图像生成才真正走向生产。
AI 音乐供给快速增长,完整歌曲的生成能力早已不再稀缺。现在,行业开始更关注专业可控性,以及更难量化的音乐品质:审美、旋律、人声和情绪表达。
音乐的特殊之处也在这里。图像是否准确,可以从文字、物体、空间关系等维度验证;音乐的评价却包含大量难以量化的因素。一段旋律是否抓耳,人声是否自然,情绪是否准确,编曲是否符合特定文化和音乐类型的审美,很难依靠传统 Benchmark 完整衡量。
今年云栖大会发布的 Happy Shrimp 1.1,进一步提升了旋律、人声、创作意图理解和多语言演唱能力。目前,模型覆盖百余种曲风和十余种主流语言,可以生成人声歌曲和纯音乐。相比 1.0,1.1 的旋律记忆点更强,人声唱法和情绪表达更加丰富,对复杂创作指令的理解进一步提升,多语言演唱的发音也更加准确、清晰。
Happy Shrimp 1.1 引入了 音乐审美建模与强化学习,将旋律、律动、声部清晰度、空间定位和音色自然度纳入更精细的奖励反馈。也就是说,音乐性本身开始成为模型的优化目标。
这种变化首先体现在旋律和编排上。Happy Shrimp 1.1 强化了旋律的记忆点,让主题能够在重复、变化和再现中保持辨识度;编排则进一步处理配器、声部和律动,让主歌、副歌、桥段等不同部分承担各自的段落功能,推动整首作品的情绪发展。
在人声生成上,准确只是基础,唱法和情绪同样决定最终的听感。Happy Shrimp 1.1 提升了多语种演唱的准确性和清晰度,也增加了唱法和情绪表达的丰富度。目前,模型覆盖百余种曲风和十余种主流语言。
但“好听”没有一套统一标准。不同年代、文化和音乐类型,都有各自的旋律、配器、律动和演唱习惯。除了音乐审美,模型还需要把创作者相对抽象的描述,转换成具体的音乐选择。
比如用户只给出“雨夜返乡,克制的喜悦”,模型需要判断什么样的曲风和配器符合对应的文化语境,什么样的唱法适合这种情绪,律动应该有多强,段落又应该如何展开。
Happy Shrimp 1.1 通过世界知识增强音乐理解与生成,将文化语境和场景意图进一步对应到曲风、音色、律动和结构。
对于普通用户,目标是降低从一个想法到一首完整歌曲的门槛。在 Happy Shrimp(快乐虾米)里,用户可以从一句想法开始,描述故事、情绪和风格,生成一首人声歌曲或纯音乐;歌词可以自己写,也可以由 AI 辅助完成。
专业音乐人的需求则不同。他们需要保留自己的创作判断,并对旋律、编曲、人声和其他元素拥有更细的控制。一次生成之后,还需要继续修改、比较和选择版本。
Happy Shrimp 1.1 支持多模态参考、局部编辑和多轮创作。例如一次 Remix 可以要求模型“保留 A 的旋律,用 B 的编曲风格与 C 的音色重新演绎”;局部修改副歌鼓组时,则只增强鼓组的冲击力,同时保护旋律、人声和其他段落。
这次发布会上,在预告新一代视频生成模型发布时间的同时,郑波公布了阿里巴巴对视频模型演进方向的判断。
视频模型已经从早期的 DiT 验证阶段,走向多模态参考创作,并开始进入理解创作的阶段。
最早的 DiT 验证阶段,核心是先把视频生成出来,解决生成质量问题。今年上半年开始,多模态参考能力快速演进,模型能够同时理解文字、图片、视频和音频,视频生成也从相对单一的输入走向多模态创作。郑波表示,目前市场上绝大部分用户都已经在使用多模态参考。
而现在,阿里巴巴的视频生成模型正在迈向下一个阶段:在生成素材的同时,进一步理解创作目标和创作意图。
模型需要更懂叙事和镜头,能够从一个想法、一个故事出发,自动拆解剪辑和分镜,组织角色与场景,再完成最终生成。再往后,阿里巴巴还在探索将理解、推理、生成和交互进一步统一,让 AI 从生成内容走向理解创作、参与创作和完成创作。
沿着这个方向,阿里巴巴下一代视频模型将会朝“ 更长、更可控、更完整、更智能” 四个方向提升。
“更长”,是在更长时间里保持人物、场景和内容的一致性,讲完一个完整故事;“更可控”,是让创作者更精确地控制人物、场景、镜头和其他创作元素;“更完整”,是从生成单个镜头走向理解剧情、情绪和完整叙事;“更智能”,则是更好地理解创作意图。
一段几秒的视频,还可以用 Prompt 描述人物、动作和镜头。到了几十秒甚至更长的视频,人物如何移动、摄影机沿什么轨迹运动、角色在空间中的位置如何变化,都需要持续控制。并且,除了文本、图片、视频和音频,3D 白模、2D Layout、运动轨迹、人物姿态、深度信息和相机几何这些模态,也可以成为视频生成的控制条件。并且不同条件作用的对象、时间和范围不同,视频生成工具还需处理跨时间的约束、工具调用,以及人物和场景等素材的持续复用。
阿里巴巴因此提出了 Agentic PE(智能体式创作引擎)辅助生成体系,用来组织复杂任务和长时域生成所需的多模态条件。
Agentic PE 先根据生成任务,确定需要哪些控制条件,再调用工具构建和组织这些条件。条件可以包括空间布局、运动轨迹、人物姿态、深度、参考图像和视频,以及相机几何信息。对于长时段生成,它还会规划不同时间段的约束,并持续更新条件。为提高效率,它会检索和复用已有素材,并根据任务要求和时延选择控制精度。同时,推理时使用的控制信号需要在模型训练阶段得到支持,才能在生成时发挥作用。
多模态预训练与 Agentic PE 配合,可以让视频在持续生成的过程中保持可控,支持长视频和实时流式生成。预训练让模型学会使用图像、姿态、轨迹等条件。Agentic PE 则负责组织、构建和更新这些条件。
对于长视频,持续的条件约束有助于保持前后内容一致,让变化符合创作要求。对于实时流式生成,条件可以随着新输入逐步更新,引导后续画面,实现边生成、边交互。
阿里巴巴同时在探索理解与生成的统一建模。让理解、思考与规划、视觉生成共享表征并联合训练,同时保留不同模态的输出头或专家。
过去几年,图像、音乐和视频生成主要沿着各自的技术路线发展。现在,生成任务正在变得更加复杂:文本之外,图像、视频、音频,以及轨迹、相机参数、3D 几何等信息,都开始成为生成条件。
图片开始从一次生成走向可编辑、可继续生产的视觉资产;音乐开始从生成完整歌曲,走向对旋律、审美和创作意图更细致的控制;视频则开始处理更长的叙事、更复杂的条件,并进一步探索实时流式生成。
更丰富的多模态输入、更完整的创作能力,以及实时生成与交互,正在带着 AI 从生成内容,走向创造体验。
正文由 FLUX 从来源站点 RSS 同步,内容未经改写;遇到排版缺失或需要图片、视频时请以原文为准。